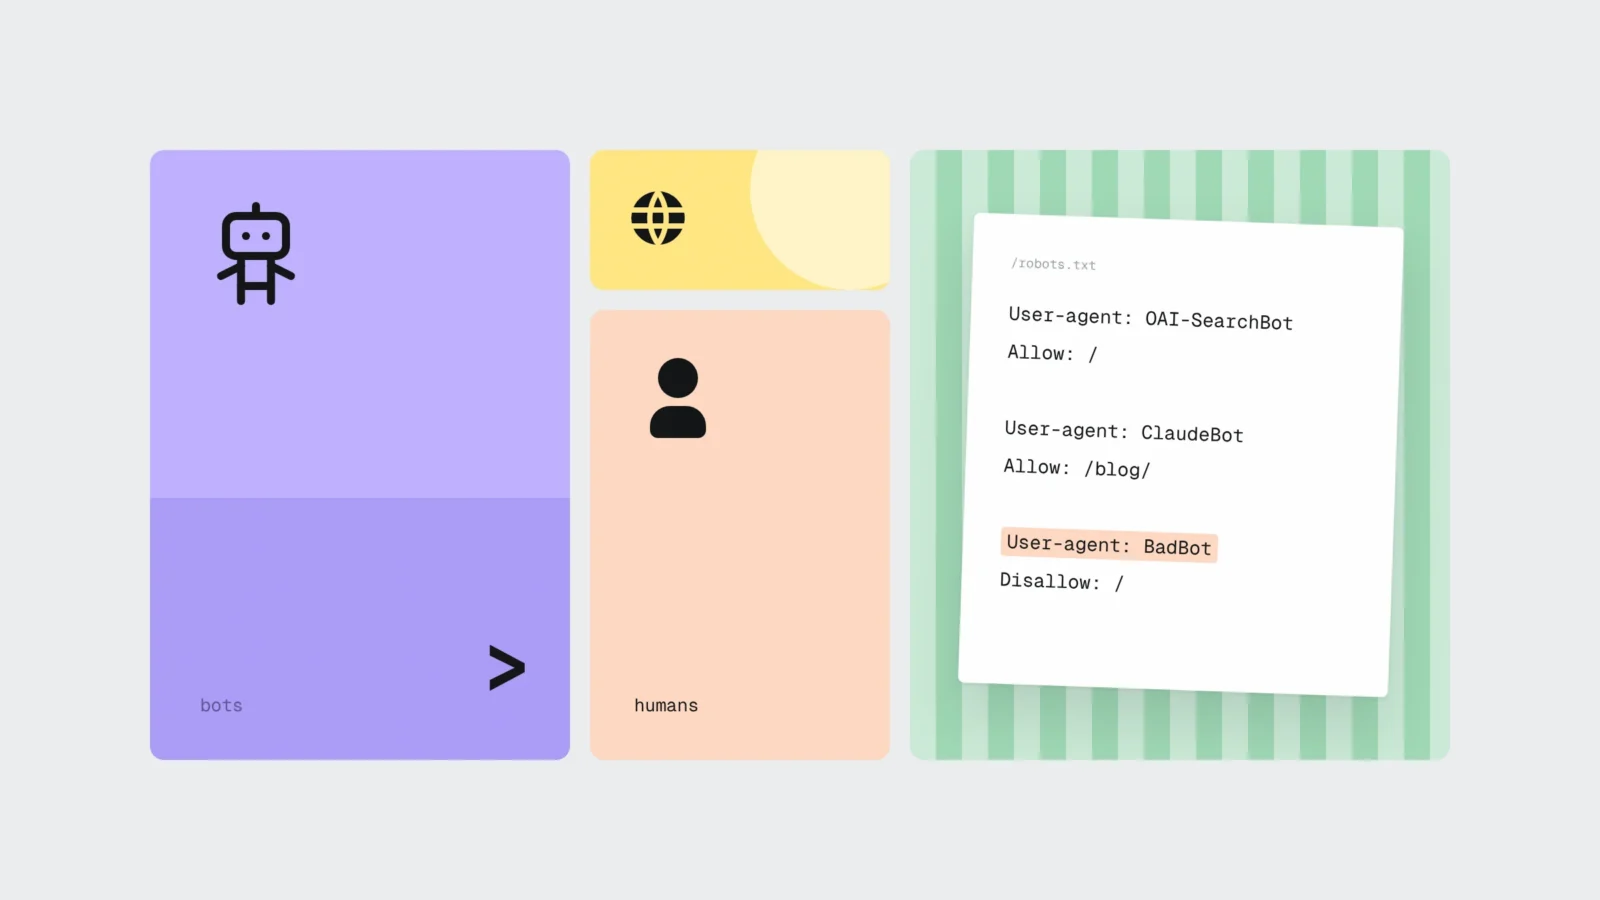
Vairāk nekā puse pieprasījumu, kas 2026. gadā nonāk līdz mājaslapām, nāk no robotiem. Cloudflare vadītājs Metjū Prinss 3. jūnijā, atsaucoties uz Cloudflare Radar datiem, minēja attiecību 57,5 % pret 42,5 % robotu labā, un Cloudflare septembra pārskatā to apstiprina: šogad pirmo reizi lielākā daļa interneta datplūsmas nav cilvēki. Mājaslapas īpašniekam robotus der dalīt trīs grupās. Meklētājus un AI meklēšanas botus (Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot, PerplexityBot) laidiet, ja gribat parādīties Google, ChatGPT, Claude un Perplexity atbildēs. Modeļu apmācības botus (GPTBot, ClaudeBot, Google-Extended, CCBot) izvērtējiet: to bloķēšana neizņem lapu no meklēšanas rezultātiem. Skrāpētājus un agresīvus rīkus, kas noslogo serveri, bloķējiet vai ierobežojiet ar Cloudflare vai drošības spraudni, jo robots.txt fails viņiem ir tikai lūgums.
Kas apmeklē jūsu mājaslapu
Lielie AI uzņēmumi sava rāpuļa vietā tagad lieto vairākus, katru savam mērķim, un katram ir savs nosaukums (user-agent), ko var minēt robots.txt failā. OpenAI, Anthropic un Perplexity dokumentācijā raksta, ka katrs iestatījums darbojas atsevišķi: bloķējot vienu botu, pārējie turpina strādāt. Praktiski tos var sadalīt četrās grupās.
- Klasiskie meklētāji. Googlebot veido Google meklēšanas indeksu, arī Discover un visām meklēšanas funkcijām. Bingbot dara to pašu Bing meklētājam.
- AI meklēšanas boti. OAI-SearchBot (ChatGPT meklēšana), Claude-SearchBot (Claude) un PerplexityBot (Perplexity) indeksē lapas, lai tās varētu parādīt un saistīt atbildēs. OpenAI un Perplexity šos botus iesaka atļaut, ja gribat parādīties to meklēšanas rezultātos. Perplexity raksta, ka PerplexityBot dati netiek izmantoti modeļu apmācībai.
- Lietotāja pieprasītie boti. ChatGPT-User, Claude-User un Perplexity-User atver lapu tad, kad cilvēks asistentam uzdod jautājumu vai iedod saiti. Tie nerāpo pa visu internetu. OpenAI un Perplexity atklāti raksta, ka šiem botiem robots.txt noteikumi var nedarboties, jo pieprasījumu sāka cilvēks.
- Modeļu apmācības boti. GPTBot (OpenAI), ClaudeBot (Anthropic) un CCBot (Common Crawl publiskais arhīvs, ko plaši izmanto valodu modeļu apmācībā) vāc saturu, ko var izmantot nākamo modeļu apmācībai. Google-Extended nav atsevišķs rāpulis: tas ir robots.txt vārds, ar kuru pasakāt, vai Googlebot savākto saturu drīkst izmantot Gemini modeļu apmācībai un atbilžu pamatošanai Gemini lietotnē.
Ārpus šīm grupām ir viss pārējais: SEO rīku rāpuļi, cenu salīdzinātāji, satura kopētāji, ievainojamību skeneri un roboti, kas aizpilda formas. Daļa no tiem sevi nosauc godīgi, daļa izliekas par parastu Chrome pārlūku.
Laist: meklētāji un AI meklēšanas boti
Ja lapai jāatved klienti, Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot un PerplexityBot jāatļauj. Bloķēts OAI-SearchBot nozīmē, ka lapa neparādīsies ChatGPT meklēšanas atbildēs kā avots, labākajā gadījumā tikai kā navigācijas saite. Anthropic par Claude-SearchBot raksta līdzīgi: bloķēšana var samazināt lapas redzamību un precizitāti Claude atbildēs. Lietotāja pieprasītos botus bloķēt nav jēgas pakalpojumu uzņēmumam: ja cilvēks pats iedod asistentam jūsu saiti, labāk, lai asistents to var izlasīt.
Google AI pārskati (AI Overviews) un AI režīms balstās uz to pašu indeksu, ko veido Googlebot. Google AI optimizācijas ceļvedī ir noteikums: lapai jābūt piemērotai rādīšanai meklēšanā ar fragmentu (snippet). Tāpēc lapa, kas aizvērta Googlebot, nevar parādīties arī Google AI atbildēs. Vairāk par to, kā AI asistenti izvēlas, kuru uzņēmumu ieteikt, rakstījām rakstā GEO 2026: kāpēc ChatGPT iesaka jūsu konkurentu.
Šīs grupas botus visbiežāk bloķē nejauši. Tipiski iemesli ir izstrādes laikā atstāta robots.txt rinda “Disallow: /” zem “User-agent: *”, drošības spraudnis, kas bloķē visus nezināmos botus, vai hostinga ugunsmūris, kas datu centru IP adreses uzskata par uzbrucējiem. Lapa izskatās normāli, bet ChatGPT un Perplexity to neredz.
Izvērtēt: modeļu apmācības boti
Apmācības boti lapai klientus tieši neatved. Tie paņem saturu, un nākotnē modelis par jūsu nozari zinās vairāk. Cloudflare 2025. gada augusta mērījumos Anthropic rāpuļi uz katru apmeklētāju, ko tie atsūtīja atpakaļ, ielādēja ap 50 000 HTML lapu, OpenAI 887, Perplexity 118. Google šajā salīdzinājumā nebija, jo tā rāpulis vienlaikus kalpo meklēšanai, kas atved lielāko daļu apmeklētāju.
Lēmums atkarīgs no tā, kas lapā ir vērtīgs. Pakalpojumu uzņēmumam, viesu namam vai būvfirmai apraksti, cenas un kontakti nav noslēpums, un tas, ka modelis zina jūsu nosaukumu un pilsētu, drīzāk palīdz. Savā lapā dizainsweb.lv atļaujam gan meklēšanas, gan apmācības botus, jo gribam, lai mūsu raksti nonāk atbildēs. Izdevējam, kursu autoram vai uzņēmumam ar maksas saturu situācija ir cita: viņu teksts ir produkts, un apmācības botus parasti bloķē.
Svarīgi zināt, ko kurš bloķējums dara:
- GPTBot bloķēšana neietekmē OAI-SearchBot. OpenAI raksta, ka, ja atļauti abi, viena rāpošanas rezultātus var izmantot abiem mērķiem.
- Google-Extended bloķēšana neizņem lapu no Google meklēšanas un nav ranžēšanas signāls. Google dokumentācijā tas rakstīts tieši.
- ClaudeBot un CCBot atbalsta rindu Crawl-delay, kas liek botam starp pieprasījumiem nogaidīt norādīto sekunžu skaitu. Googlebot šo rindu neņem vērā.
- Cloudflare datos 36,6 % pārbaudīto rāpuļu datplūsmas veido jauktie rāpuļi, kas vienlaikus veido meklēšanas indeksu un vāc apmācības datus. Tos bloķējot, zaudējat arī meklēšanu.
Bloķēt vai ierobežot: skrāpētāji un agresīvi rīki
Trešā grupa ir tā, kas lapai reāli kaitē. Satura kopētāji pārpublicē jūsu tekstus un cenas, SEO rīku rāpuļi, ko jūs pats nelietojat, pārlasa tūkstošiem adrešu katru nedēļu, bet ievainojamību skeneri meklē wp-login.php, xmlrpc.php un vecus spraudņu failus. Spraudņu riskus sīkāk aprakstījām rakstā WordPress spraudņi kā drošības risks.
Godīgie no tiem (AhrefsBot, SemrushBot un līdzīgi) robots.txt ievēro, un tos var aizvērt ar divām rindām. Pārējos robots.txt neaptur. Te vajag servera līmeņa rīku: Cloudflare botu aizsardzību, hostinga ugunsmūri vai WordPress drošības spraudni ar pieprasījumu limitu. Cloudflare kopš 2026. gada jūlija ļauj atsevišķi pārvaldīt meklēšanas, aģentu un apmācības botus, arī bezmaksas plānā. Jaunām vietnēm no 15. septembra apmācības un aģentu boti pēc noklusējuma ir bloķēti lapās ar reklāmām, bet meklēšana ir atļauta. Ja lapa jau ir aiz Cloudflare, ieejiet iestatījumos un pārbaudiet, kas ir ieslēgts, jo noklusējums var nesakrist ar jūsu lēmumu.
Kāpēc robots.txt neaizsargā lapu
robots.txt ir 1994. gadā radīta vienošanās, ko 2022. gadā aprakstīja standarts RFC 9309. Standarts pats saka, ka šie noteikumi “are not a form of access authorization”, tātad tie nav piekļuves kontrole. Godīgs bots failu izlasa un ievēro, ļaunprātīgs to ignorē vai pat izmanto kā sarakstu ar adresēm, ko jūs negribat rādīt. Tāpēc robots.txt nekad neslēpj administrācijas paneli, klientu failus vai testa vidi. Tos aizsargā parole un servera iestatījumi.
Arī lielie uzņēmumi ne vienmēr spēlē pēc noteikumiem. 2025. gada augustā Cloudflare publicēja testu: Perplexity deklarētie boti testa vietnēs bija bloķēti, bet Perplexity tāpat atbildēja ar šo vietņu saturu, jo izmantoja nedeklarētu rāpuli, kas izlikās par Chrome pārlūku macOS datorā un mainīja IP adreses. Cloudflare pēc tam izņēma Perplexity no pārbaudīto botu saraksta.
Viens tehnisks sīkums rada daudz kļūdu. Ja botam robots.txt failā ir sava grupa, vispārīgo grupu “User-agent: *” tas vairs neņem vērā. Ja ClaudeBot grupā ierakstāt tikai Crawl-delay, ClaudeBot drīkst iet arī uz adresēm, ko vispārīgajā grupā aizliedzāt. Aizliegumi jāatkārto katrā grupā:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /*?date=
Disallow: /?s=

User-agent: AhrefsBot
User-agent: SemrushBot
Disallow: /

User-agent: ClaudeBot
User-agent: CCBot
Crawl-delay: 5
Disallow: /wp-admin/
Disallow: /*?date=
Disallow: /?s=

Sitemap: https://example.lv/sitemap.xml
Izmaiņas nestrādā uzreiz. OpenAI un Perplexity raksta, ka sistēmas jaunos noteikumus ņem vērā aptuveni 24 stundu laikā, Google robots.txt saglabā kešatmiņā parasti līdz 24 stundām.
Ko darīt ar llms.txt
llms.txt ir 2024. gadā piedāvāts faila formāts, kurā lapa valodu modeļiem īsi apraksta savu saturu. Oficiāls standarts tas nav. Google AI optimizācijas ceļvedī (atjaunināts 10.07.2026) raksta, ka Google meklēšana šādus failus neizmanto un tie redzamību ne uzlabo, ne pasliktina. Citi pakalpojumi tos var lasīt, tāpēc fails nekaitē, bet bloķēšanas vai atļaušanas lēmumus tas neaizstāj. Robotiem saistošs ir tikai robots.txt un servera iestatījumi.
Ko boti dara ar servera ātrumu, analītiku un formām
Lēta hostinga plānam ir CPU un vienlaicīgo procesu limits. WordPress lapa bez kešatmiņas katru pieprasījumu ģenerē no jauna, un, ja vakarā vienlaikus nāk viesi un trīs rāpuļi, kas pārlasa kalendāra vai filtru adreses, serveris sāk atbildēt lēni vai ar kļūdu 503. Cilvēks redz lēnu lapu, Googlebot redz lēnu serveri un rāpo mazāk.
Analītikā boti rada divu veidu kļūdas. Hostinga statistika (AWStats, Webalizer, cPanel atskaites) skaita servera žurnāla ierakstus, un tur nāk līdzi daudzi boti, kas sevi neatklāj. Google Analytics 4 zināmos botus izslēdz automātiski pēc Google pētījumiem un IAB botu saraksta, un šo filtru nevar izslēgt vai apskatīt, cik izslēgts. Turklāt GA4 skaita tikai tos, kas palaiž JavaScript un piekrīt sīkdatnēm. Tāpēc atšķirība 5-10 reizes starp hostinga statistiku un GA4 ir normāla. Toties boti, kas atveido īstu pārlūku, var nonākt arī GA4 kā dīvaini apmeklējumi ar 0 sekundēm uz lapas no vienas valsts. Kā mērīt AI meklēšanas ietekmi uz klikšķiem, aprakstīsim atsevišķā rakstā.
Formas ir trešā vieta. Robots, kas aizpilda kontaktu formu, piepilda pastkastīti ar reklāmu un var sabojāt jūsu domēna e-pasta reputāciju, ja forma sūta apstiprinājuma vēstuli uz norādīto adresi. Ja forma pieņem failus, robots var mēģināt augšupielādēt kaitīgu kodu. Pret to palīdz neredzams lauks (honeypot), Cloudflare Turnstile vai reCAPTCHA un pieprasījumu limits vienai IP adresei.
Piemērs: viesu nams Daugavpilī
Pieņemsim, ka viesu namam Daugavpilī ir WordPress lapa latviešu, angļu un krievu valodā ar rezervāciju kalendāru. Hostinga panelī ir 38 000 apmeklējumu mēnesī, bet GA4 rāda ap 4100. Īpašniece sūdzas, ka vakaros lapa atveras 4-6 sekundēs, un pāris reizes mēnesī rezervācijas forma atgriež kļūdu. Pa kontaktu formu nāk ap 40 surogātpasta vēstulēm nedēļā.
Servera žurnāls par 30 dienām parāda ainu. No 1,6 miljoniem pieprasījumu 74 % nāk no botiem. Lielākā daļa ir rīki, kas pārlasa kalendāra adreses ar parametru ?date= katrai dienai uz trim gadiem uz priekšu, katrā valodā. Tādu adrešu ir desmitiem tūkstošu, un katra prasa serverim izrēķināt pieejamību. Otrajā vietā ir divi SEO rīku rāpuļi, ko viesu nams nelieto. Tad nāk apmācības boti, un ap 9 % ir pieprasījumi no datu centru IP adresēm ar Chrome nosaukumu, kas 19.00-23.00 nāk pa 20-30 sekundē. Hostinga plāns tieši šajās stundās sasniedz CPU limitu 11 reizes mēnesī.
Ko izdarīja:
- robots.txt aizvēra kalendāra parametru adreses visām grupām un pilnībā aizvēra abus SEO rīku rāpuļus;
- atstāja Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot, PerplexityBot un lietotāja botus, jo viesus meklē arī caur ChatGPT un Google AI atbildēm;
- apmācības botus atstāja, jo istabu apraksti un cenas nav noslēpums, bet ClaudeBot un CCBot iestatīja Crawl-delay 5 sekundes;
- lapu ielika aiz Cloudflare bezmaksas plāna, ieslēdza botu aizsardzību un kalendāra adresēm uzlika limitu 30 pieprasījumi minūtē vienai IP adresei;
- kontaktu un rezervācijas formai pievienoja Turnstile un neredzamu lauku, kalendāra lapām ieslēdza kešatmiņu.
Pēc 30 dienām botu pieprasījumu ir par 62 % mazāk, un vakara servera atbildes laiks (TTFB) samazinājās no 2,8 s līdz 0,6 s. CPU limits netika sasniegts ne reizi, rezervācijas forma kļūdas vairs neatdod. Hostinga statistika rāda ap 9800 apmeklējumu, GA4 ap 4200, tātad cilvēku skaits palika tāds pats, un iepriekšējie 38 000 bija galvenokārt boti. Surogātpasts samazinājās līdz 1-2 vēstulēm nedēļā. Search Console pēc mēneša rāda, ka Googlebot lapas ielādē ātrāk un indeksēto lapu skaits nav mainījies.
Pārbaude 6 soļos
- Atveriet robots.txt. Ierakstiet pārlūkā jūsulapa.lv/robots.txt. Meklējiet “Disallow: /” zem “User-agent: *” vai zem Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot un PerplexityBot. Pārbaudiet, vai katrā bota grupā ir atkārtoti vajadzīgie aizliegumi.
- Salīdziniet hostinga statistiku ar GA4. Ja hostings rāda 5 reizes vairāk apmeklējumu nekā GA4, tā ir botu datplūsma. Ja 20 reizes vairāk, ir vērts apskatīt servera žurnālu.
- Izlasiet servera žurnālu. Hostinga panelī lejupielādējiet piekļuves žurnālu (access log) par pēdējo nedēļu un sakārtojiet pēc user-agent un IP. Meklējiet adreses ar parametriem, kas atkārtojas tūkstošiem reižu, un IP adreses, kas sūta desmitiem pieprasījumu sekundē.
- Pārbaudiet botu pārvaldību. Ja lapa ir aiz Cloudflare, sadaļā par AI rāpuļiem pārbaudiet, vai meklēšana ir atļauta. Ja lietojat Wordfence, Solid Security vai līdzīgu spraudni, pārbaudiet pieprasījumu limitus un to, vai tas nebloķē zināmos meklēšanas botus.
- Pārbaudiet, vai bots ir īsts. Google, OpenAI, Anthropic un Perplexity publicē savu botu IP adrešu sarakstus. Ja “Googlebot” nāk no adreses, kas nav Google sarakstā, tas ir viltojums, un to var bloķēt bez riska.
- Aizsargājiet formas. Pievienojiet neredzamu lauku un Turnstile vai reCAPTCHA, ierobežojiet pieprasījumu skaitu no vienas IP un pēc nedēļas saskaitiet surogātpasta vēstules.
Ko izdarīt šonedēļ
- Atveriet savas lapas robots.txt un pārbaudiet, vai meklēšanas boti nav bloķēti.
- Izlemiet, vai atļaujat GPTBot, ClaudeBot, Google-Extended un CCBot.
- Katrā bota grupā atkārtojiet vispārīgos aizliegumus.
- Salīdziniet hostinga statistiku ar GA4 par pēdējo mēnesi.
- Aizveriet kalendāra, filtru un meklēšanas parametru adreses.
- Pārbaudiet Cloudflare vai drošības spraudņa botu iestatījumus.
- Pievienojiet formām neredzamu lauku un Turnstile vai reCAPTCHA.
Biežāk uzdotie jautājumi
Vai bloķēt GPTBot savā mājaslapā?
Tas atkarīgs no satura. GPTBot vāc datus OpenAI modeļu apmācībai, un tā bloķēšana neietekmē OAI-SearchBot, kas parāda lapas ChatGPT meklēšanā. Pakalpojumu uzņēmumam GPTBot parasti var atļaut. Izdevējam vai maksas satura autoram to bieži bloķē.
Vai, bloķējot Google-Extended, lapa pazudīs no Google?
Nē. Google dokumentācijā rakstīts, ka Google-Extended neietekmē iekļaušanu Google meklēšanā un nav ranžēšanas signāls. Tas nosaka tikai to, vai saturu drīkst izmantot Gemini modeļu apmācībai un atbilžu pamatošanai Gemini lietotnē un Vertex AI.
Vai robots.txt aizsargā lapu no satura kopētājiem?
Nē. robots.txt ir lūgums, ko ievēro godīgi boti. Standarts RFC 9309 pats norāda, ka tā nav piekļuves kontrole. Pret skrāpētājiem un agresīviem rīkiem vajag Cloudflare botu aizsardzību, hostinga ugunsmūri vai drošības spraudni ar pieprasījumu limitu.
Kāpēc hostinga statistika rāda daudz vairāk apmeklējumu nekā GA4?
Hostinga statistika skaita servera žurnāla ierakstus, un tajos ir daudzi boti. GA4 zināmos botus izslēdz automātiski un skaita tikai apmeklētājus, kas palaiž JavaScript un piekrīt sīkdatnēm. Atšķirība 5-10 reizes ir normāla, lielāka norāda uz botu problēmu.
Vai mājaslapai vajag llms.txt failu?
Nav obligāti. llms.txt nav oficiāls standarts, un Google raksta, ka Google meklēšana šādus failus neizmanto. Fails nekaitē un var noderēt citiem pakalpojumiem, bet botu atļaušanu un bloķēšanu nosaka robots.txt un servera iestatījumi.
Kā pārbaudīt, vai Googlebot vai GPTBot ir īsts?
Salīdziniet pieprasījuma IP adresi ar uzņēmuma publicēto sarakstu. Google, OpenAI, Anthropic un Perplexity publicē savu botu IP adreses, un Cloudflare pārbaudītos botus atpazīst automātiski. Bots ar Googlebot nosaukumu no citas adreses ir viltojums.
Lapa, kas atver durvis meklētājiem un aizver tās skrāpētājiem
Uzturēšanā robots.txt pārskatām pēc katras lielākas izmaiņas, reizi mēnesī izlasām servera žurnālu un pārbaudām, vai meklēšanas boti nav nejauši bloķēti. Ja serveri noslogo boti, ieslēdzam pieprasījumu limitus un formu aizsardzību. Mājaslapas uzturēšana maksā no 60 € + PVN mēnesī, serveris no 144 € + PVN gadā. Ja gribat, lai lapa parādās Google un AI asistentu atbildēs, sāciet ar SEO optimizāciju. Atsūtiet lapas adresi formā vai zvaniet +371 25 640 062, un pateiksim, kurus AI botus jūsu robots.txt šobrīd bloķē un cik no hostinga statistikas apmeklējumiem ir cilvēki.
Avoti
- Cloudflare: The Internet has a second audience (30.09.2026)
- Tech Times: Cloudflare Radar dati par 57,5 % botu pieprasījumu (05.06.2026)
- Cloudflare: Cloudflare Helps End the Search-or-AI-Training Tradeoff (15.09.2026)
- Cloudflare Changelog: New options to manage AI traffic (01.07.2026)
- Cloudflare: A deeper look at AI crawlers (28.08.2025)
- Cloudflare: Perplexity is using stealth, undeclared crawlers (04.08.2025)
- OpenAI: Overview of OpenAI Crawlers
- Anthropic palīdzības centrs: botu un rāpuļu apraksts
- Perplexity: Perplexity Crawlers
- Google: List of Google’s common crawlers
- Google: How Google interprets the robots.txt specification
- Google Search Central: Optimizing for generative AI features (10.07.2026)
- Google Analytics: Known bot-traffic exclusion
- Common Crawl: FAQ
- IETF RFC 9309: Robots Exclusion Protocol (2022)