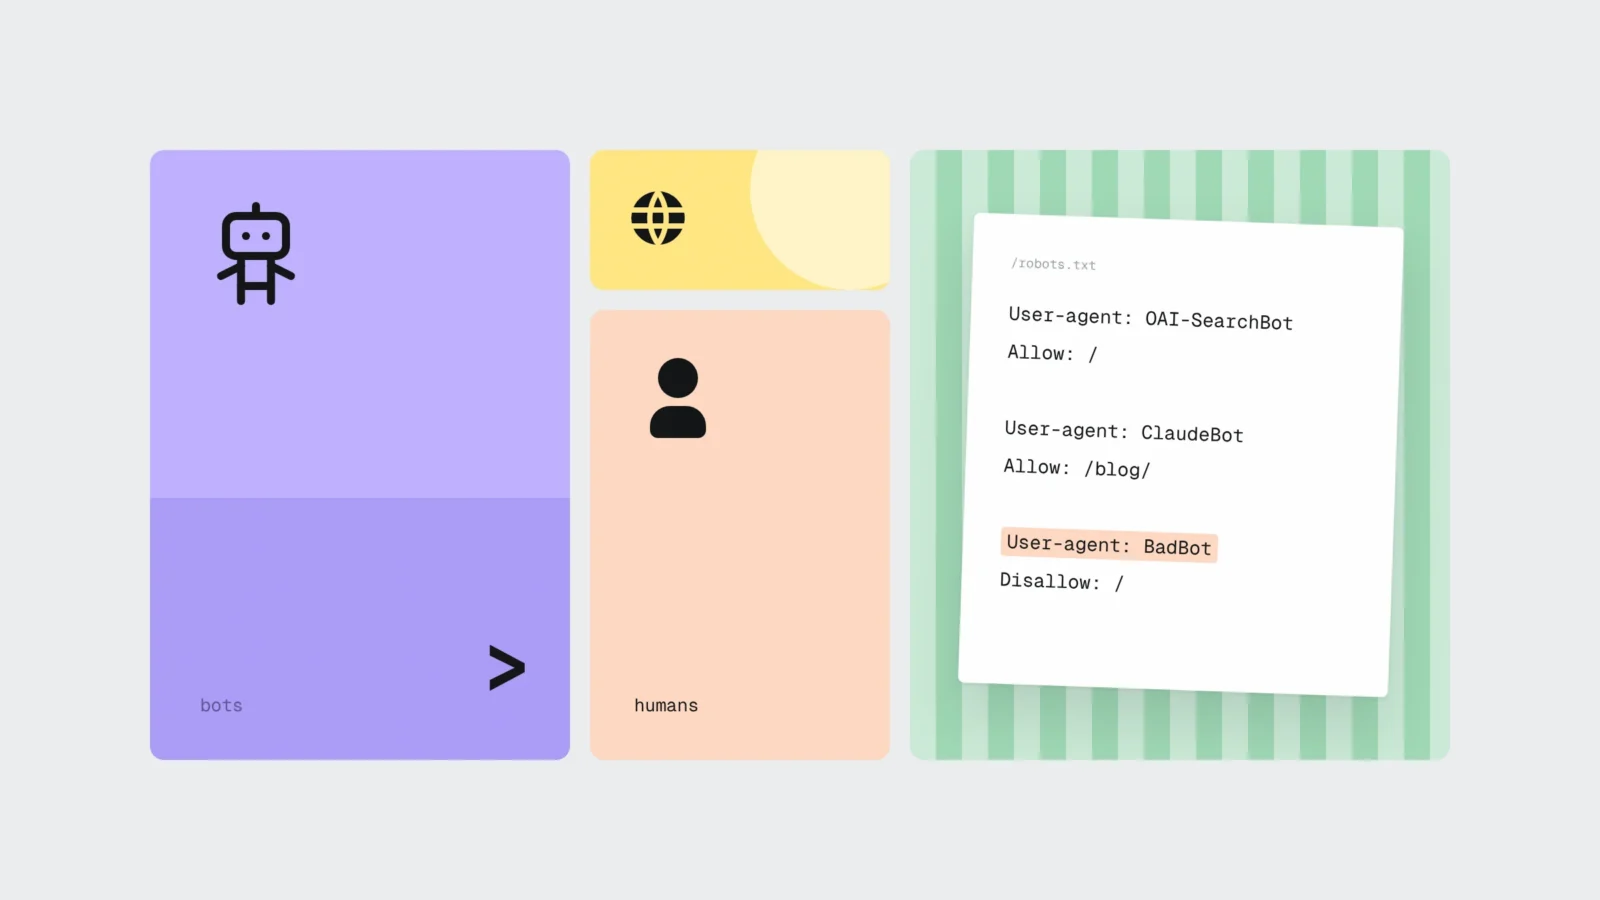
Больше половины запросов, которые в 2026 году приходят на сайты, отправляют роботы. 3 июня глава Cloudflare Мэтью Принс со ссылкой на данные Cloudflare Radar назвал соотношение 57,5 % автоматических запросов против 42,5 % человеческих, а сентябрьский отчёт Cloudflare это подтверждает: в этом году впервые большая часть интернет-трафика не от людей. Владельцу сайта роботов удобно делить на три группы. Поисковики и поисковых ИИ-ботов (Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot, PerplexityBot) пускайте, если хотите появляться в ответах Google, ChatGPT, Claude и Perplexity. Ботов для обучения моделей (GPTBot, ClaudeBot, Google-Extended, CCBot) оценивайте отдельно: их блокировка не убирает сайт из поисковой выдачи. Скраперы и агрессивные инструменты, которые нагружают сервер, блокируйте или ограничивайте через Cloudflare или плагин безопасности, потому что файл robots.txt для них лишь просьба.
Кто заходит на ваш сайт
Крупные ИИ-компании теперь используют несколько краулеров, у каждого своя задача и своё имя (user-agent), к которому можно обратиться в robots.txt. OpenAI, Anthropic и Perplexity пишут в документации, что каждая настройка работает отдельно: если заблокировать одного бота, остальные продолжат работу. На практике их можно разделить на четыре группы.
- Классические поисковики. Googlebot строит индекс поиска Google, включая Discover и все функции поиска. Bingbot делает то же самое для Bing.
- Поисковые ИИ-боты. OAI-SearchBot (поиск ChatGPT), Claude-SearchBot (Claude) и PerplexityBot (Perplexity) индексируют страницы, чтобы показывать их и ссылаться на них в ответах. OpenAI и Perplexity советуют разрешить этих ботов, если вы хотите появляться в их поиске. Perplexity пишет, что данные PerplexityBot не используются для обучения моделей.
- Боты по запросу пользователя. ChatGPT-User, Claude-User и Perplexity-User открывают страницу, когда человек задаёт ассистенту вопрос или даёт ссылку. Сами по интернету они не ходят. OpenAI и Perplexity прямо пишут, что правила robots.txt к таким ботам могут не применяться, ведь запрос начал человек.
- Боты для обучения моделей. GPTBot (OpenAI), ClaudeBot (Anthropic) и CCBot (публичный архив Common Crawl, который широко используют для обучения языковых моделей) собирают контент, который может пойти на обучение следующих моделей. Google-Extended не отдельный краулер: это слово в robots.txt, которым вы говорите Google, можно ли использовать собранный Googlebot контент для обучения моделей Gemini и для обоснования ответов в приложении Gemini.
За пределами этих групп остаётся всё прочее: краулеры SEO-сервисов, агрегаторы цен, копировщики контента, сканеры уязвимостей и роботы, заполняющие формы. Часть из них честно называет себя, часть притворяется обычным браузером Chrome.
Пускать: поисковики и поисковые ИИ-боты
Если сайт должен приводить клиентов, Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot и PerplexityBot нужно разрешить. Заблокированный OAI-SearchBot означает, что страницы не появятся источником в ответах поиска ChatGPT, в лучшем случае только навигационной ссылкой. Anthropic о Claude-SearchBot пишет похоже: блокировка может снизить видимость и точность сайта в ответах Claude. Блокировать ботов по запросу пользователя компании услуг тоже нет смысла: если человек сам даёт ассистенту вашу ссылку, лучше, чтобы ассистент мог её прочитать.
Обзоры от ИИ (AI Overviews) и режим ИИ в Google опираются на тот же индекс, который строит Googlebot. В руководстве Google по оптимизации для ИИ есть условие: страница должна подходить для показа в поиске со сниппетом. Поэтому страница, закрытая для Googlebot, не может появиться и в ИИ-ответах Google. Подробнее о том, как ИИ-ассистенты выбирают, какую компанию советовать, мы писали в статье почему ChatGPT советует вашего конкурента.
Ботов этой группы чаще всего блокируют случайно. Типичные причины: оставшаяся со времён разработки строка “Disallow: /” под “User-agent: *”, плагин безопасности, который блокирует всех неизвестных ботов, или файрвол хостинга, считающий IP-адреса дата-центров атакующими. Сайт выглядит нормально, а ChatGPT и Perplexity его не видят.
Оценить: боты для обучения моделей
Боты для обучения напрямую клиентов не приводят. Они забирают контент, и в будущем модель будет знать о вашей отрасли больше. В измерениях Cloudflare за август 2025 года краулеры Anthropic загружали около 50 000 HTML-страниц на каждого посетителя, которого возвращали на сайт, OpenAI 887, Perplexity 118. Google в этом сравнении не было, так как его краулер работает и на поиск, который приводит большинство посетителей.
Решение зависит от того, что ценного на сайте. Для компании услуг, гостевого дома или строительной фирмы описания, цены и контакты не секрет, и то, что модель знает ваше название и город, скорее помогает. На своём сайте dizainsweb.lv мы разрешаем и поисковых ботов, и ботов для обучения, потому что хотим, чтобы наши статьи попадали в ответы. У издателя, автора курсов или компании с платным контентом ситуация другая: их текст и есть продукт, и ботов для обучения обычно блокируют.
Полезно знать, что делает каждая блокировка:
- Блокировка GPTBot не влияет на OAI-SearchBot. OpenAI пишет, что если разрешены оба, результаты одного обхода могут использоваться для обеих целей.
- Блокировка Google-Extended не убирает сайт из поиска Google и не является сигналом ранжирования. В документации Google это сказано прямо.
- ClaudeBot и CCBot поддерживают строку Crawl-delay, которая заставляет бота ждать указанное число секунд между запросами. Googlebot её не учитывает.
- По данным Cloudflare, 36,6 % трафика проверенных краулеров приходится на смешанные краулеры, которые одновременно строят поисковый индекс и собирают данные для обучения. Блокируя их, вы теряете и поиск.
Блокировать или ограничивать: скраперы и агрессивные инструменты
Третья группа действительно вредит сайту. Копировщики публикуют ваши тексты и цены у себя, краулеры SEO-сервисов, которыми вы не пользуетесь, каждую неделю перечитывают тысячи адресов, а сканеры уязвимостей ищут wp-login.php, xmlrpc.php и старые файлы плагинов. О рисках плагинов мы подробнее писали в статье плагины WordPress как угроза безопасности.
Честные из них (AhrefsBot, SemrushBot и подобные) соблюдают robots.txt, и их можно закрыть двумя строками. Остальных robots.txt не останавливает. Здесь нужен инструмент на уровне сервера: защита от ботов Cloudflare, файрвол хостинга или плагин безопасности WordPress с ограничением запросов. С июля 2026 года Cloudflare позволяет отдельно управлять поисковыми ботами, агентами и ботами для обучения, в том числе на бесплатном тарифе. Для новых сайтов с 15 сентября боты для обучения и агенты по умолчанию заблокированы на страницах с рекламой, а поиск разрешён. Если сайт уже за Cloudflare, зайдите в настройки и проверьте, что включено: значение по умолчанию может не совпадать с вашим решением.
Почему robots.txt не защищает сайт
robots.txt – это договорённость 1994 года, которую в 2022 году описали в стандарте RFC 9309. Сам стандарт говорит, что эти правила “are not a form of access authorization”, то есть не являются контролем доступа. Честный бот читает файл и соблюдает его, вредоносный игнорирует или даже использует как список адресов, которые вы не хотите показывать. Поэтому robots.txt никогда не должен прятать админку, файлы клиентов или тестовую среду. Их защищают пароль и настройки сервера.
Крупные компании тоже не всегда играют по правилам. В августе 2025 года Cloudflare опубликовал тест: заявленные боты Perplexity были заблокированы на тестовых сайтах, но Perplexity всё равно отвечал их содержимым, используя незаявленный краулер, который выдавал себя за Chrome на macOS и менял IP-адреса. После этого Cloudflare исключил Perplexity из списка проверенных ботов.
Одна техническая мелочь вызывает много ошибок. Если у бота в robots.txt есть своя группа, общую группу “User-agent: *” он больше не учитывает. Если в группе ClaudeBot указать только Crawl-delay, ClaudeBot сможет заходить и на адреса, закрытые в общей группе. Запреты нужно повторять в каждой группе:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /*?date=
Disallow: /?s=

User-agent: AhrefsBot
User-agent: SemrushBot
Disallow: /

User-agent: ClaudeBot
User-agent: CCBot
Crawl-delay: 5
Disallow: /wp-admin/
Disallow: /*?date=
Disallow: /?s=

Sitemap: https://example.lv/sitemap.xml
Изменения вступают в силу не сразу. OpenAI и Perplexity пишут, что их системы учитывают новые правила примерно в течение 24 часов, а Google обычно кэширует robots.txt до 24 часов.
Что делать с llms.txt
llms.txt – это предложенный в 2024 году формат файла, в котором сайт кратко описывает свой контент для языковых моделей. Официальным стандартом он не является. В руководстве Google по оптимизации для ИИ (обновлено 10.07.2026) сказано, что поиск Google такие файлы не использует и они не улучшают и не ухудшают видимость. Другие сервисы могут их читать, так что файл не вредит, но решений о разрешении и блокировке не заменяет. Для роботов обязательны только robots.txt и настройки сервера.
Что боты делают со скоростью сервера, аналитикой и формами
У дешёвых тарифов хостинга есть лимит на процессор и одновременные процессы. Сайт на WordPress без кэша собирает каждую страницу заново, и когда вечером одновременно приходят гости и три краулера, перебирающие адреса календаря или фильтров, сервер начинает отвечать медленно или с ошибкой 503. Человек видит медленный сайт, Googlebot видит медленный сервер и обходит меньше страниц.
В аналитике боты дают два вида ошибок. Статистика хостинга (AWStats, Webalizer, отчёты cPanel) считает записи в журнале сервера, и туда попадает много ботов, которые себя не раскрывают. Google Analytics 4 автоматически исключает известных ботов по исследованиям Google и списку ботов IAB, и этот фильтр нельзя отключить или посмотреть, сколько исключено. К тому же GA4 считает только тех, кто выполняет JavaScript и соглашается на cookies. Поэтому разница в 5-10 раз между статистикой хостинга и GA4 нормальна. Зато боты, которые управляют настоящим браузером, могут попасть и в GA4 как странные визиты по 0 секунд из одной страны. Как измерять влияние ИИ-поиска на клики, расскажем в отдельной статье.
Формы – третье слабое место. Робот, заполняющий контактную форму, забивает почту спамом и может испортить почтовую репутацию вашего домена, если форма отправляет подтверждение на указанный адрес. Если форма принимает файлы, робот может попытаться загрузить вредоносный код. Против этого помогают скрытое поле (honeypot), Cloudflare Turnstile или reCAPTCHA и лимит запросов с одного IP.
Пример: гостевой дом в Даугавпилсе
Допустим, у гостевого дома в Даугавпилсе сайт на WordPress на латышском, английском и русском с календарём бронирования. Панель хостинга показывает 38 000 посещений в месяц, а GA4 около 4100. Хозяйка жалуется, что вечером сайт открывается 4-6 секунд, а пару раз в месяц форма бронирования выдаёт ошибку. Через контактную форму приходит около 40 спам-писем в неделю.
Журнал сервера за 30 дней показывает картину. Из 1,6 миллиона запросов 74 % приходят от ботов. Больше всего инструментов, которые перебирают адреса календаря с параметром ?date= на каждый день на три года вперёд, на каждом языке. Таких адресов десятки тысяч, и для каждого сервер рассчитывает доступность. На втором месте два краулера SEO-сервисов, которыми гостевой дом не пользуется. Дальше боты для обучения, а около 9 % составляют запросы с IP-адресов дата-центров под именем Chrome, которые с 19.00 до 23.00 приходят по 20-30 в секунду. Именно в эти часы тариф хостинга 11 раз в месяц упирается в лимит процессора.
Что сделали:
- в robots.txt закрыли адреса с параметрами календаря для всех групп и полностью закрыли оба краулера SEO-сервисов;
- оставили Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot, PerplexityBot и ботов по запросу пользователя, потому что гости ищут жильё и через ChatGPT, и через ИИ-ответы Google;
- ботов для обучения оставили, так как описания номеров и цены не секрет, но для ClaudeBot и CCBot задали Crawl-delay 5 секунд;
- подключили бесплатный тариф Cloudflare, включили защиту от ботов и для адресов календаря поставили лимит 30 запросов в минуту с одного IP;
- в контактную форму и форму бронирования добавили Turnstile и скрытое поле, для страниц календаря включили кэш.
Через 30 дней запросов от ботов на 62 % меньше, а время ответа сервера вечером (TTFB) снизилось с 2,8 с до 0,6 с. Лимит процессора не был достигнут ни разу, форма бронирования больше не выдаёт ошибок. Статистика хостинга показывает около 9800 посещений, GA4 около 4200, то есть людей столько же, а прежние 38 000 были в основном ботами. Спам сократился до 1-2 писем в неделю. Через месяц Search Console показывает, что Googlebot загружает страницы быстрее, а число проиндексированных страниц не изменилось.
Проверка в 6 шагов
- Откройте robots.txt. Наберите в браузере вашсайт.lv/robots.txt. Ищите “Disallow: /” под “User-agent: *” или под Googlebot, Bingbot, OAI-SearchBot, Claude-SearchBot и PerplexityBot. Проверьте, что в каждой группе бота повторены нужные запреты.
- Сравните статистику хостинга с GA4. Если хостинг показывает в 5 раз больше посещений, чем GA4, это трафик ботов. Если в 20 раз больше, стоит заглянуть в журнал сервера.
- Прочитайте журнал сервера. Скачайте в панели хостинга журнал доступа (access log) за последнюю неделю и отсортируйте по user-agent и IP. Ищите адреса с параметрами, которые повторяются тысячи раз, и IP-адреса, отправляющие десятки запросов в секунду.
- Проверьте управление ботами. Если сайт за Cloudflare, убедитесь, что в настройках ИИ-краулеров поиск разрешён. Если вы используете Wordfence, Solid Security или похожий плагин, проверьте лимиты запросов и то, что он не блокирует известных поисковых ботов.
- Проверьте, настоящий ли бот. Google, OpenAI, Anthropic и Perplexity публикуют списки IP-адресов своих ботов. “Googlebot” с адреса, которого нет в списке Google, подделка, и его можно спокойно блокировать.
- Защитите формы. Добавьте скрытое поле и Turnstile или reCAPTCHA, ограничьте число запросов с одного IP и через неделю посчитайте спам-письма.
Что сделать на этой неделе
- Откройте robots.txt своего сайта и проверьте, что поисковые боты не заблокированы.
- Решите, разрешаете ли вы GPTBot, ClaudeBot, Google-Extended и CCBot.
- Повторите общие запреты в каждой группе бота.
- Сравните статистику хостинга с GA4 за последний месяц.
- Закройте адреса с параметрами календаря, фильтров и поиска.
- Проверьте настройки ботов в Cloudflare или плагине безопасности.
- Добавьте в формы скрытое поле и Turnstile или reCAPTCHA.
Часто задаваемые вопросы
Нужно ли блокировать GPTBot на сайте?
Зависит от контента. GPTBot собирает данные для обучения моделей OpenAI, и его блокировка не влияет на OAI-SearchBot, который показывает страницы в поиске ChatGPT. Компании услуг GPTBot обычно можно разрешить. Издатели и авторы платного контента его часто блокируют.
Исчезнет ли сайт из Google, если заблокировать Google-Extended?
Нет. В документации Google сказано, что Google-Extended не влияет на включение в поиск Google и не является сигналом ранжирования. Он определяет только, можно ли использовать контент для обучения моделей Gemini и обоснования ответов в приложении Gemini и Vertex AI.
Защищает ли robots.txt сайт от копировщиков контента?
Нет. robots.txt – это просьба, которую соблюдают честные боты. Стандарт RFC 9309 сам указывает, что это не контроль доступа. Против скраперов и агрессивных инструментов нужны защита от ботов Cloudflare, файрвол хостинга или плагин безопасности с лимитом запросов.
Почему статистика хостинга показывает намного больше посещений, чем GA4?
Статистика хостинга считает записи журнала сервера, а в них много ботов. GA4 автоматически исключает известных ботов и считает только посетителей, которые выполняют JavaScript и соглашаются на cookies. Разница в 5-10 раз нормальна, большая указывает на проблему с ботами.
Нужен ли сайту файл llms.txt?
Не обязательно. llms.txt не является официальным стандартом, и Google пишет, что поиск Google такие файлы не использует. Файл не вредит и может пригодиться другим сервисам, но разрешение и блокировку ботов определяют robots.txt и настройки сервера.
Как проверить, настоящий ли Googlebot или GPTBot?
Сравните IP-адрес запроса со списком, который публикует компания. Google, OpenAI, Anthropic и Perplexity публикуют IP-адреса своих ботов, а Cloudflare распознаёт проверенных ботов автоматически. Бот с именем Googlebot с другого адреса – подделка.
Сайт, открытый для поисковиков и закрытый для скраперов
В рамках обслуживания мы пересматриваем robots.txt после каждого крупного изменения, раз в месяц читаем журнал сервера и проверяем, не заблокированы ли случайно поисковые боты. Если сервер нагружают боты, включаем лимиты запросов и защиту форм. Обслуживание сайта стоит от 60 € + НДС в месяц, сервер от 144 € + НДС в год. Если хотите, чтобы сайт появлялся в ответах Google и ИИ-ассистентов, начните с SEO-продвижения. Отправьте адрес сайта через форму или позвоните +371 25 640 062, и мы скажем, каких ИИ-ботов ваш robots.txt сейчас блокирует и сколько посещений в статистике хостинга приходится на людей.
Источники
- Cloudflare: The Internet has a second audience (30.09.2026)
- Tech Times: данные Cloudflare Radar о 57,5 % запросов от ботов (05.06.2026)
- Cloudflare: Cloudflare Helps End the Search-or-AI-Training Tradeoff (15.09.2026)
- Cloudflare Changelog: New options to manage AI traffic (01.07.2026)
- Cloudflare: A deeper look at AI crawlers (28.08.2025)
- Cloudflare: Perplexity is using stealth, undeclared crawlers (04.08.2025)
- OpenAI: Overview of OpenAI Crawlers
- Справочный центр Anthropic: боты и краулеры
- Perplexity: Perplexity Crawlers
- Google: List of Google’s common crawlers
- Google: How Google interprets the robots.txt specification
- Google Search Central: Optimizing for generative AI features (10.07.2026)
- Google Analytics: Known bot-traffic exclusion
- Common Crawl: FAQ
- IETF RFC 9309: Robots Exclusion Protocol (2022)